vstHeatmapWithClustering creates an expression heatmap from VST-transformed counts and groups genes by their temporal expression patterns.
The function uses three R packages: pheatmap, reshape2, and ggplot2.
Outputs
Starting from a VST-transformed matrix from the time-series DESeq2 workflow:
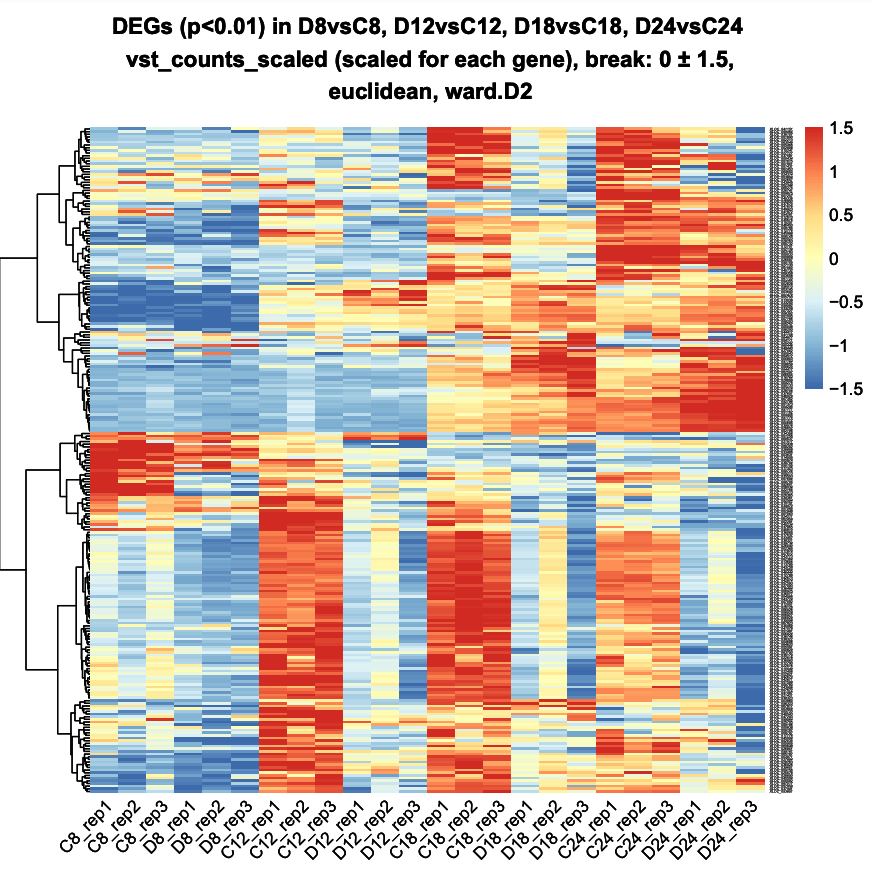
- Figure 1: Plot a heatmap with clustered genes.
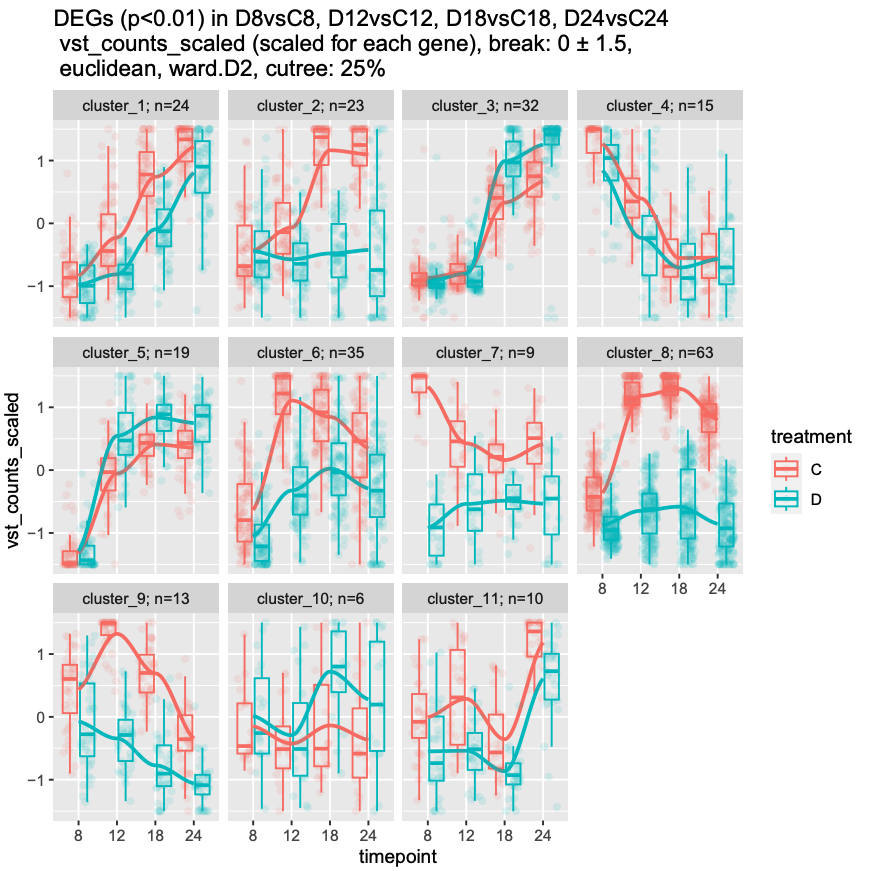
- Figure 2: plot gene-expression trajectories over time and group genes with similar temporal patterns.
- Each gene will be scaled in
vstHeatmapWithClustering
Example
Inputs
vst_matrix
- Required to be a vst transformed matrix.
- colnames (i.e., sample names) required to be “treatment + timepoint + replicate” with** delimited syntax:**
| ctrl_8.rep1 | ctrl_8.rep2 | ctrl_8.rep3 | d_8.rep1 | d_8.rep2 | d_8.rep3 |
metadata
- The metadata used in DESeq2.
group_rep_delim
- The delimiter between
groupandreplicate number
treatment_timepoint_delim
- The delimiter between
treatmentandtimepoint
PatternCluster
- Whether to produce the temporal-pattern plot (Figure 2).
Code to define the vstHeatmapWithClustering** function**
# visualize the heatmap (vst counts) and pattern clustering plot

# matrix has to be vst() output
# colnames has to be "treatment+timepoint_replicate" (e.g., "C8_rep1")

# Written by Chun-Ting Lin <jordan841220@gmail.com>, Aug 2023


vstHeatmapWithClustering <- function(vst_matrix = vst_matrix, # matrix has to be vst() output
                                       metadata = metadata, # metadata
                                       value_break = 1.5, # default: 0 +- 1,5
                                       heatmap_title = "Heatmap",
                                       clustering_distance_rows = "euclidean",
                                       clustering_method = "ward.D2",
                                       fontsize_row = 2,
                                       angle_col = "45",
                                       PatternCluster = FALSE,
                                       group_rep_delim = ".", # delim between group and replicate number
                                       treatment_timepoint_delim = "_", # delim between treatment and timepoint
                                       PatternCluster_height = 0.25,
                                       PatternCluster_csv.file = "cluster_results.csv",
                                       PatternCluster_txt.file = "cluster_results.txt",
                                       PatternCluster_boxplot_alpha = 0.1,
                                       PatternCluster_boxplot_dodge = 0.9,
                                       PatternCluster_smooth_span = 0.7,
                                       PatternCluster_point_alpha = 0.1,
                                       PatternCluster_point_dodge = 0.9,
                                       PatternCluster_title = "Pattern"){
  if (missing(group_rep_delim)) {
          stop("delim between timepoint and repicate in sample name is missing.")}
  else if (missing(treatment_timepoint_delim)) { stop("delim between treatment and timepoint in sample name is missing.") }
           else {
  # scale and centering
  # (because scale() work on each column, t() is necessary if we want to scale each genes)
  matrix_scale <- t(scale(t(vst_matrix)))
  matrix_scale_df <- as.data.frame(matrix_scale)

  # set color and break
  matrix_scale_df[matrix_scale_df < -value_break] <- -value_break
  matrix_scale_df[matrix_scale_df > value_break] <- value_break


  newnames <- lapply(
    rownames(matrix_scale_df),
    function(x) bquote(italic(.(x))))

  ################################
  # heatmap (for all timepoint and treatment)
  ###################################
  ph <- pheatmap::pheatmap(matrix_scale_df,
                           show_rownames = T,
                           breaks=seq(from=-value_break, to=value_break, length=101),
                           fontsize_row = fontsize_row,
                           labels_row = as.expression(newnames),
                           cluster_col=FALSE,
                           angle_col = angle_col,
                           cluster_rows = TRUE,
                           clustering_distance_rows = clustering_distance_rows,
                           clustering_method = clustering_method,
                           border_color = NA,
                           main = heatmap_title)

  if (PatternCluster) {

    ###################################
    # extract clustering results
    ###################################

    # say i want to cut at 25% height of the dendrogram
    cluster_df_1 <- cbind(matrix_scale_df,
                          cluster = cutree(ph$tree_row,
                                           h= PatternCluster_height*max(ph$tree_row$height)))
    cluster_df <- cluster_df_1


    cluster_df$cluster <- lapply(cluster_df_1$cluster, function(x) paste0('cluster_',x))
    cluster_df <- tibble::rownames_to_column(cluster_df, "Gene")

    # convert this data frame to the "classical" format
    cluster_df <- as.data.frame(lapply(cluster_df, unlist))
    write.csv(cluster_df,
              file = PatternCluster_csv.file,
              row.names = F)
    write.table(cluster_df,
                file = PatternCluster_txt.file,
                row.names = F,
                col.names = T,
                quote = F,
                sep = '\t')


    ###################################
    # prepare for ggplot2
    ###################################
    # melt
    cluster_df <- reshape2::melt(cluster_df, id = c("Gene","cluster"))
    colnames(cluster_df) <- c("Gene","cluster","sample","expression")

    # split "C8_rep1" to "C8" and "rep1"...
    cluster_df <- tidyr::separate_wider_delim(cluster_df,
                                              cols = sample,
                                              delim = group_rep_delim,
                                              names = c("sample", "replicate"))

    # extract treatment and timepoint columns
    cluster_df <-
      tidyr::separate_wider_delim(cluster_df,
                                  cols = sample,
                                  delim = treatment_timepoint_delim,
                                  names = c("treatment", "timepoint"))

    # factor the column so facet_wrap can arrange facet alphabetically
    cluster_df$treatment <- factor(cluster_df$treatment, levels = levels(metadata$treatment))
    cluster_df$timepoint <- factor(cluster_df$timepoint, levels = levels(metadata$timepoint))
    cluster_df$replicate <- factor(cluster_df$replicate, levels = levels(metadata$rep))

    cluster_df$cluster <- factor(cluster_df$cluster,
                                 levels = paste0("cluster_",1:max(cluster_df_1$cluster)))

    # add the number of genes
    cluster_df <-
      cluster_df %>%
      group_by(cluster) %>%
      mutate(cluster_count = n_distinct(Gene)) %>%
      ungroup() %>%
      mutate(facet_label = paste0(cluster,
                                  "; n=", cluster_count))

    # factor the facet_label column so facet_wrap can arrange facet alphabetically
    cluster_df$facet_label <- factor(cluster_df$facet_label,
                                     levels = unique(cluster_df$facet_label))

    plot_PatternCluster <- ggplot(cluster_df) +
      geom_boxplot(aes(x=timepoint,
                       y=expression,
                       color=treatment),
                   alpha = PatternCluster_boxplot_alpha,
                   outlier.colour = NA,
                   position=position_dodge(width=PatternCluster_boxplot_dodge)) +
      geom_smooth(aes(x = as.numeric(factor(timepoint)),
                      y = expression,
                      color = treatment),
                  span = PatternCluster_smooth_span,
                  se = F,
                  method = "loess")+
      geom_point(aes(x = as.numeric(factor(timepoint)),
                     y = expression,
                     color = treatment),
                 alpha = PatternCluster_point_alpha,
                 position=position_jitterdodge(dodge.width=PatternCluster_point_dodge)) +
      facet_wrap(~facet_label) +
      ggtitle(PatternCluster_title)


    return(list(ph,plot_PatternCluster))

  } else {
    return(ph)
  }
  }
}